|
|
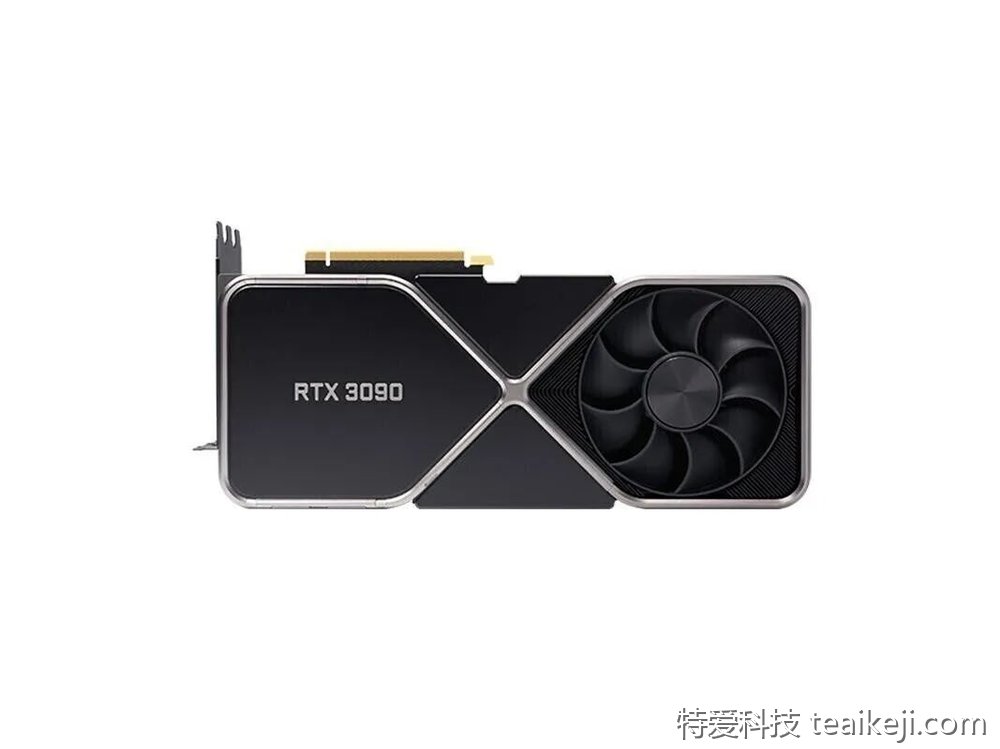
两张3090,9成新也好,老卡也好,很多人都在做同一件事:绑一起跑大模型。显存是大了,但第二张卡从此失去独立身份,只能跟着第一张一起排队。真正让两张3090物尽其用的,不是堆显存,而是分工。一张负责模型推理,另一张负责图像生成。夜里让 agent 自动派单,写稿、出图可以并行。
方法并不复杂,关键只有一个环境变量和一次服务重启,耗时大约五分钟。
我用的环境如下:Z690 HERO 主板、i5-12490F、32G DDR5-6000、Windows 10、NVIDIA 驱动 616.92、Ollama 0.33.0、ComfyUI portable 0.37.1。两张3090分别插在两条 x8 槽上,没有额外花活。
先别急着把两张卡绑成48G。Ollama 作为常驻服务,默认按总显存分配资源。只要两张卡都可见,它可能把模型层拆到两张卡上。表面上显存更宽裕,但每层计算后都要跨卡搬运中间结果,额外通信会拖慢整体速度。
我用的27B Q4版本约17G,一张24G卡装下后,还剩约7G空间放上下文。第二张卡本来没有出场机会。硬拆的结果,是满额任务量,实际效率却打八折。
目标状态应该长这样:0号卡常驻大模型,1号卡基本空闲,随时能接活。
用下面命令看显存:
我的结果:0号卡22651 MiB,1号卡571 MiB。
0号卡上是一个27B模型,256K上下文全部放在显存里。再看服务状态:
显示100% GPU,模型常驻不释放。1号卡基本是空的,只有显示输出的底占用,随时可以交给 ComfyUI。
这不是48G拼一块大卡,而是两条独立生产线。
第一步,给大模型指定一张卡。需要设置系统级变量:
- CUDA_VISIBLE_DEVICES=GPU-...
这里填的是目标卡的 UUID,也就是 nvidia-smi 里 GPU- 开头的那串。不要填0或1,同型号双卡重启后序号可能变化,UUID才稳定指向同一块物理卡。查询命令:
- nvidia-smi --query-gpu=index,uuid --format=csv,noheader
第二步,优化KV缓存。为了让256K上下文塞进单卡,设置:
- OLLAMA_KV_CACHE_TYPE = q4_0
如果想让模型尽量吃满整张卡,不留CPU余量,再设置:
第三步,退出 Ollama 托盘图标,再重新启动。很多人卡在这一步。它读取的是启动时的环境,不重启前面设置无效。注意是退出托盘再启动,不是关窗口。
验证是否成功:
跑一个任务后,用下面命令盯两张卡:
目标卡应从几百M升到20G以上并稳定,另一张基本不动。如果两张同时上涨,说明切分没关,要重来。
再看:
100% GPU、上下文262144是正确状态。如果出现CPU字样,说明有层掉出显存,KV没有全部进卡。
再喂128K长任务压一下,目标卡占用应在20G上下稳定。如果在18到22G之间反复跳,说明仍有批次跨卡,要回头查变量。
我的实测:0号卡22651 MiB,1号卡571 MiB,三关都过。
常见坑:
- 改了变量没重启 Ollama,等于没改。
- 填了0/1序号,同型号双卡重启后可能对调,必须用UUID。
- 变量只挂用户级,某些启动方式读不到,钉卡相关建议统一挂系统级。
- 如果还留着下面这个变量,它会主动切卡,和钉卡冲突,删掉:
- 单卡装得下的模型硬切分,通信开销白付,小模型反而可能变慢。
钉完大模型后,1号卡完全空闲。ComfyUI portable 自带 Python,启动前同样先声明它要用的卡,把它的 UUID 设置进去。启动参数里必须带:
不加这个参数,ComfyUI 可能钉住约90%物理内存,32G机器在跑大模型时容易被内核 OOM 干掉。同配置下,加上后我的实测内存占用从29.8G降到7.5G。这不是可选项。
出图时,1号卡会涨到15-20G,0号卡那22.6G基本不动,验证通过。
最有用的是两张卡能同时干活。给 agent 一句“写篇文章,配三张插图”:0号卡负责写文、拆提示词;1号卡负责出图;图再回0号卡,让27B自己审,因为它原生能看图;不满意就改词重出,满意就继续下一段。
9月底跑短剧时,0号卡挂着22.7G的大模型写剧本、审分镜,1号卡同时在烤 LTX 2.5 的17.5G,两边互不等待,两条流水线并行。
别只盯着生图:
“一张大模型、一张干活”是通用结构,干活内容可以换。社区里常见玩法:
- 有人把4090卖了,组成双3090,用48G做8bit微调7B;更极限的玩法还有双3090 QLoRA 微调70B。
- 主力卡负责聊天和写代码,副卡半夜自动捞论文、打标签。
- 3090本身是渲染卡出身,突发渲染负载和常驻推理节奏正好错开。
- 如果上NVLink,可以把48G当一块卡用,适合纯模型训练/推理场景。
具体选哪种,看日常负载。前提都是先把卡钉住,后面才能换负载。
买卡前显存优先:
跑模型那张卡,显存是第一指标。模型权重和KV缓存都要进显存,加起来超过容量就会掉到CPU,速度会断崖。
24GB正好是27B Q4的甜点:模型约17G进卡,剩约7G放上下文。往上换70B,单卡塞不下,分工结构直接塌方。往下换7B/14B,显存富裕,但能力不够。
现阶段消费级本地,27B稠密Q4基本是最优解:单卡装得下、原生能看图、支持262K上下文和原生工具调用、Apache 2.0可商用。选卡顺序很简单:显存优先,算力其次。12G上限基本是14B封顶,多花一倍钱往往只是token速度更快。
第二张3090买的不是48G显存,而是一条独立生产线。钉卡五分钟的活,换来一张卡24小时不用排队。
你家另一张卡在干嘛?评论区说说,看看谁还有更野的用法。觉得有用先收藏,别等划走了找不到。 |
|